فتحتَ محادثة قبل ساعتين وحددتَ فيها تعليمات دقيقة، ثم لاحظتَ أن الرد الأخير تجاهل نصفها. هذا لا يعني دائمًا أن النموذج «غبي» أو «ملّ منك»؛ قد يكون سبب ذلك أن المحادثة صارت تزاحم حدود ما يستطيع الاحتفاظ به أمامه: نافذة السياق.
نافذة السياق: كل ما يقرؤه النموذج لحظة الرد
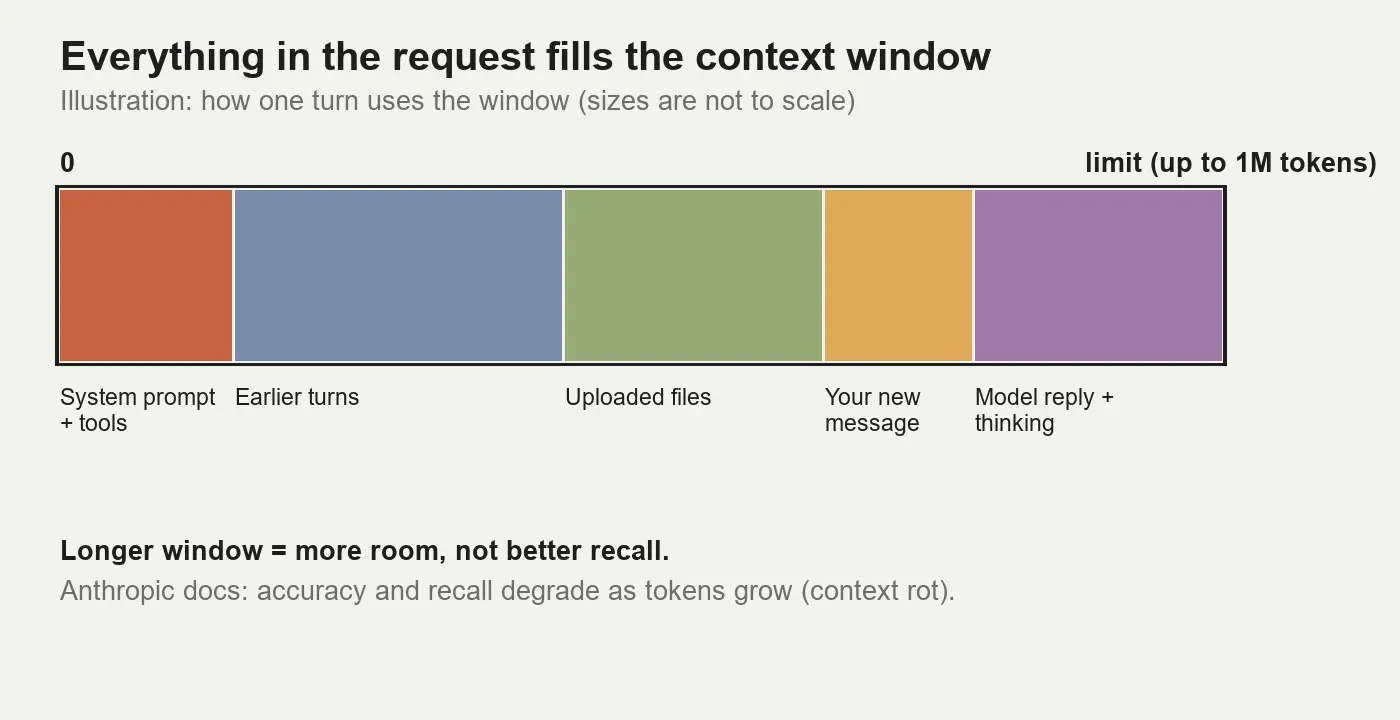
تعرّفها وثائق Anthropic بأنها كل النص الذي يستطيع النموذج الرجوع إليه وهو يكتب ردًا، بما في ذلك الرد نفسه. وتشبهها بـ«ذاكرة العمل»، وتفرّقها عن البيانات الضخمة التي تدرّب عليها النموذج. أي أن النموذج لا «يتذكر» محادثتك من مكان خفي؛ في كل رد يُعاد إليه سجل المحادثة كله ليقرأه من جديد، وما يخرج من النافذة لا يراه.
وليس سجل الدردشة وحده ما يملؤها. تقول وثائق Anthropic إن كل ما في الطلب يُحتسب: تعليمات النظام، والرسائل، ونتائج الأدوات، والصور والمستندات، وتعريفات الأدوات، ثم الرد نفسه وما فيه من تفكير.
التوكن: الوحدة التي تُقاس بها النافذة
النافذة لا تُقاس بالكلمات بل بالتوكن، وهو جزء من كلمة أو حرف أو كلمة كاملة. تقول Google لنماذج Gemini إن التوكن يساوي نحو 4 أحرف، وإن كل 100 توكن تساوي نحو 60 إلى 80 كلمة إنجليزية. وللوسائط حساب آخر في وثائق Google:
| المحتوى | ما يستهلكه (بحسب وثائق Gemini) |
|---|---|
| صورة 384 بكسل أو أقل في البعدين | 258 توكن |
| صورة أكبر | تُقسَّم إلى بلاطات 768×768، وكل بلاطة 258 توكن |
| صوت | 32 توكن في الثانية |
| فيديو | 263 توكن في الثانية |
كم تبلغ النافذة اليوم؟
تذكر Anthropic أن نماذجها الحديثة، ومنها Fable 5.2 وOpus 5.5 وSonnet 5.5 وHaiku 5.5، لها نافذة 1M توكن (مليون)، وأن الطلب الواحد قد يولّد حتى 128 ألف توكن إخراج. وتذكر Google أن نماذج Gemini 4 تتشارك نافذة من 1,048,576 توكن تشمل الإدخال والتفكير والإخراج. هذه أرقام واجهات المطورين، وقد تختلف حدود تطبيقات الدردشة حسب الخطة؛ وتقول Anthropic إن واجهات مثل claude.ai قد تدير النافذة بأسلوب «الأقدم يخرج أولًا».
لماذا تتراجع الجودة قبل أن تمتلئ النافذة؟
تحذر Anthropic في الوثائق نفسها من أن النافذة الأكبر لا تعني دائمًا نتيجة أفضل: مع نمو عدد التوكنات تتراجع الدقة والتذكر، وتسمي ذلك «تعفّن السياق» (context rot). وتشير تقارير ثانوية إلى دراسة لشركة Chroma عام 2025 على 18 نموذجًا وجدت أن الأداء يهبط كلما طال الإدخال؛ لم أفتح الدراسة نفسها، فاعتبرها دلالة لا رقمًا نهائيًا. ولو امتلأت النافذة فعليًا: ترفض الواجهة البرمجية طلبًا يتجاوز النافذة بخطأ «prompt is too long»، وتقترح Anthropic «الضغط» (compaction)، أي تلخيص الجزء الأقدم من المحادثة، وهو ما زال beta.
- افتح محادثة لكل موضوعلا تجمع ميزانية البيت وخطة السفر ورسالة العمل في سلسلة واحدة.
- كرّر التعليمات المهمةإن طالت المحادثة فألصق قواعدك في رسالة جديدة بدل الاعتماد على أول رسالة.
- لخّص ثم ابدأ من جديداطلب ملخصًا من النموذج، وانسخه إلى محادثة جديدة نظيفة.
- ارفع ما تحتاجه فقطفصل واحد أفضل من الكتاب كله إن كان سؤالك عن الفصل.
هذه الخطوات اقتراحات عملية مني مبنية على ما سبق، وليست إعدادات رسمية في تطبيق بعينه. وإن كان ما يقلقك هو اختلاق النموذج للمعلومات فاقرأ لماذا يخترع ChatGPT معلومة بثقة، ولحدود رفع الملفات في Gemini هذا الدليل، ولفهم كيف تُحوَّل الكلمات إلى أرقام شرح Embeddings.
هل النافذة الأكبر تعني ذاكرة أطول؟
لا بالضرورة؛ هي مساحة أكبر يقرؤها النموذج في الرد الواحد، وتقول Anthropic إن الدقة والتذكر قد يتراجعان مع طول السياق.
هل الذاكرة المحفوظة في ChatGPT هي نافذة السياق نفسها؟
لا، لها آلية منفصلة عن النافذة، وقد شرحنا كيف تُمحى في مقالة حذف المحادثة والذاكرة.