الـ Embedding هو قائمة أرقام تمثّل معنى نص أو صورة؛ فإذا تقاربت الأرقام تقارب المعنى، حتى لو اختلفت الكلمات. بهذا يجد الذكاء الاصطناعي «سيارة» حين تبحث عن «مركبة».
تخيّل مكتبة لا تُرتَّب كتبها بالحروف، بل بالمواضيع: كل كتاب له إحداثيات على خريطة، وما كان قريبًا في الموضوع يقع بجواره. الـ Embeddings هي هذه الإحداثيات، لكن بمئات الأبعاد بدل اثنين.
ما الذي يفعله ذلك عمليًا؟
- البحث بالمعنى: تكتب «طريقة تسريع الجوال» فتصلك مقالات عنوانها «تحسين أداء الهاتف».
- RAG: يستخرج المقاطع المناسبة من مستنداتك ثم يمررها للنموذج؛ وقد شرحنا الفكرة في مقال RAG.
- التوصية والتصنيف: تجميع الرسائل المتشابهة أو اقتراح محتوى قريب مما قرأت.
نموذج حديث كمثال: EmbeddingGemma 2
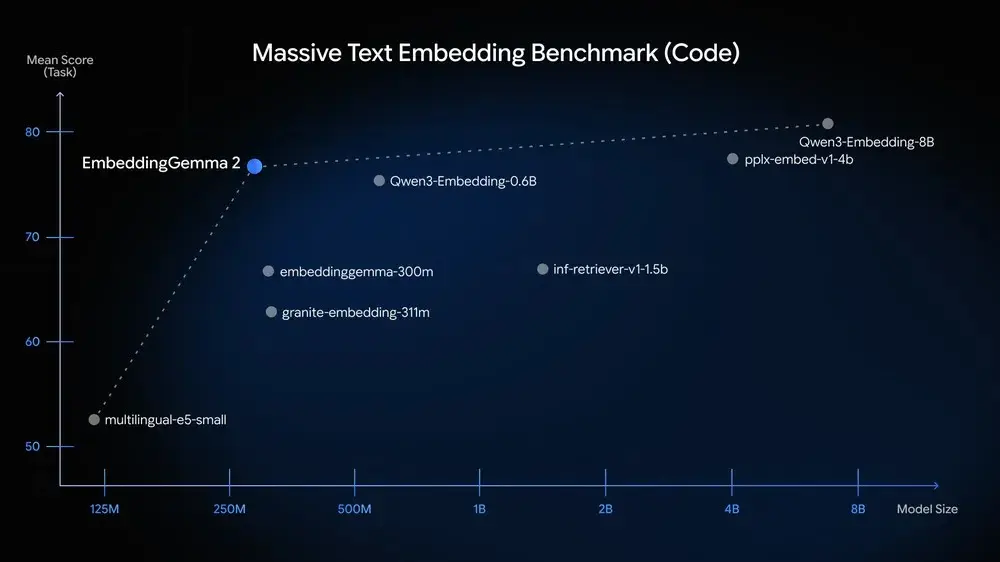
أصدرت Google في 6 أكتوبر 2026 نموذج EmbeddingGemma 2، وتقول إنه يحوّل النص والصور والفيديو والصوت والشيفرة إلى فضاء متجهات واحد. أبرز ما في بطاقته:
| الخاصية | القيمة بحسب Google |
|---|---|
| الحجم | 740 مليون معامل (270 مليونًا للنص فقط) |
| السياق | 8000 توكن |
| الأبعاد | من 768 قابلة للتقليص حتى 128 |
| الذاكرة | نحو 191 ميغابايت للنص فقط، ونحو 567 للنسخة المتعددة الوسائط (جهاز Pixel 11 Pro مع التكميم) |
| الترخيص | Apache 2.0 |
يتوفر على Hugging Face وKaggle ومنصة Google AI Edge. وتزعم Google أنه يتفوق على نماذج بحجم ضعفه، وهو ادعاء الشركة نفسها (عنوان تقرير The Decoder: «Google claims»).
أسئلة شائعة
هل الـ Embeddings هي نفسها نموذج المحادثة؟
لا. نموذج المحادثة يكتب الجواب، أما نموذج الـ Embeddings فيقيس القرب بين المعاني ويعيد أرقامًا لا نصوصًا.
لماذا يهمني تقليص الأبعاد؟
أقل أبعادًا تعني تخزينًا أصغر وبحثًا أسرع، مقابل دقة أقل قليلًا. تذكر Google أن النموذج يقلّل حجم قاعدة المتجهات حتى ست مرات.
هل أحتاجها كمستخدم عادي؟
لن تتعامل معها مباشرة غالبًا، لكنها تعمل خلف البحث الذكي في التطبيقات، وما يصل إلى النموذج بعدها محكوم بحدود نافذة السياق.